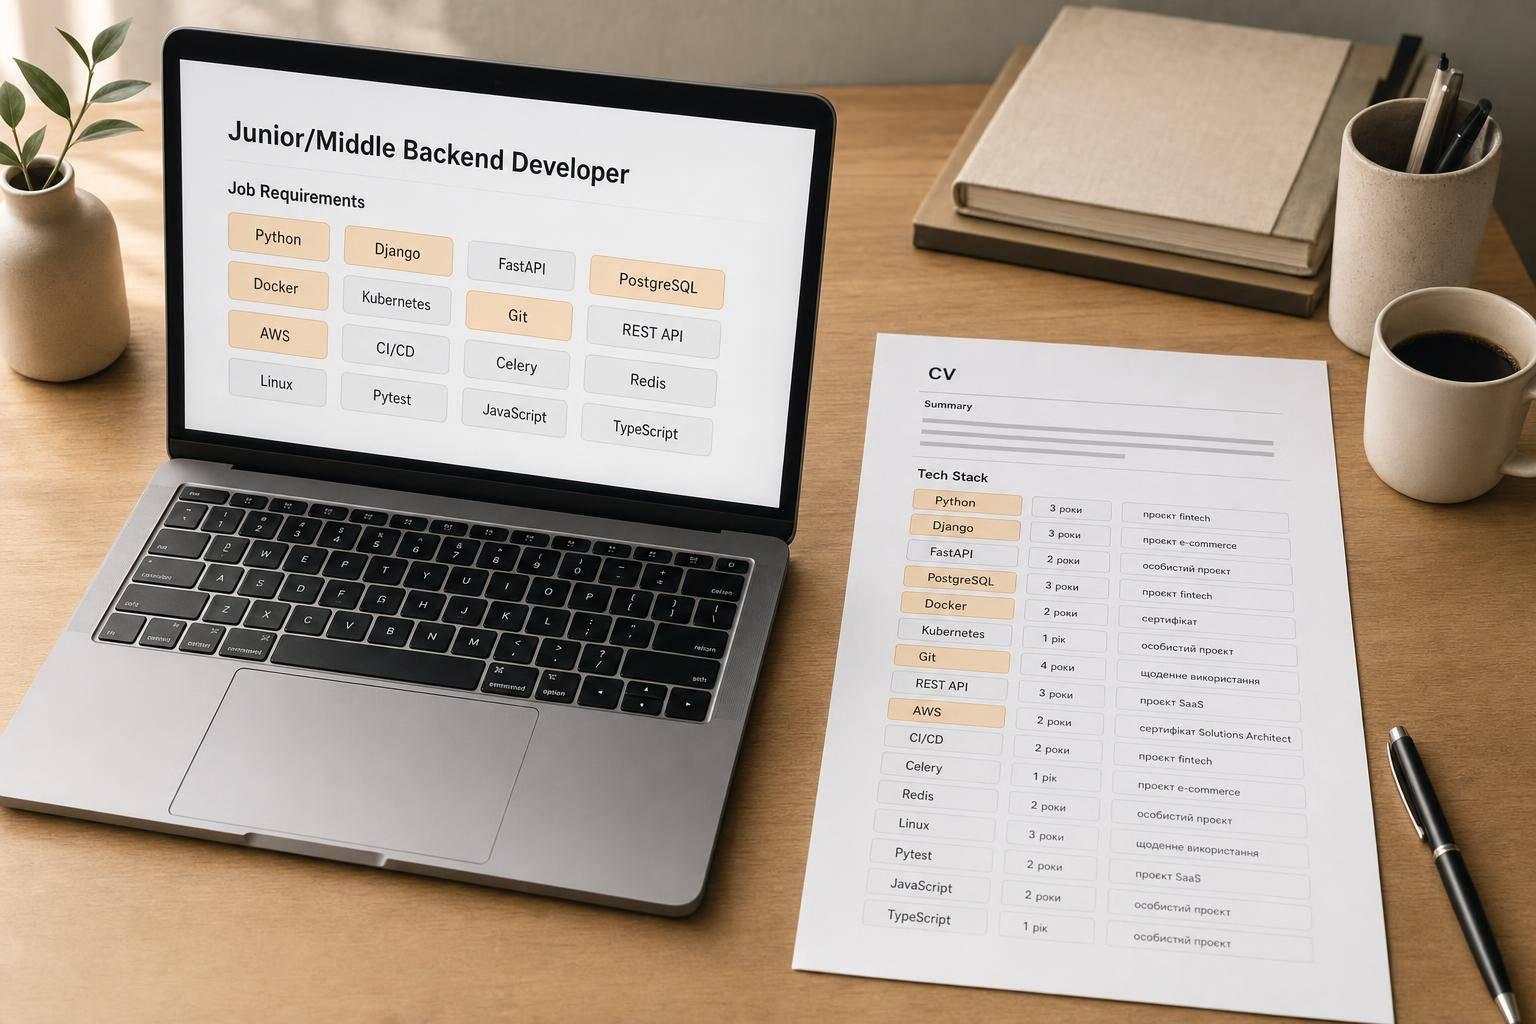
Якщо стек у CV названий не так, як у вакансії, ваше CV можуть відсіяти ще до перегляду рекрутером. Я б звів увесь матеріал до простої думки: AI дивиться не лише на навички, а й на точні формулювання, місце згадки в CV та зв’язок із досвідом.
Я бачу тут 5 головних правил:
- Пишіть назви технологій так, як їх часто пишуть у вакансіях: JavaScript, а не лише JS.
- Дублюйте стек у кількох місцях: у заголовку, Skills і Experience.
- Підтверджуйте кожну важливу технологію досвідом: не просто Python, а Python, 3 роки, FastAPI у production.
- Тримайте CV простим для ATS: одна колонка, без шкал, таблиць і зайвої графіки.
- Обережно ставте include/exclude фільтри: занадто широкі дають шум, занадто вузькі – ріжуть охоплення.
Окремо я б звернув увагу на один факт: навіть 1 слово може вплинути на матчинг. Наприклад, “REST API” і “API development” – не завжди те саме для системи. А технологія в Skills без згадки в досвіді часто має нижчу вагу.
Нижче – коротка звірка того, що найчастіше працює краще.
| Що дивиться AI | Що я б зробив у CV |
|---|---|
| Точні збіги назв | Писав би стандартні назви зі вакансій |
| Порядок секцій | Ставив би стек у верхню частину CV |
| Skills без контексту | Додавав би підтвердження в Experience |
| Різні варіанти назв | Додавав би синоніми в дужках |
| Формат документа | Лишав би одноколонковий шаблон |
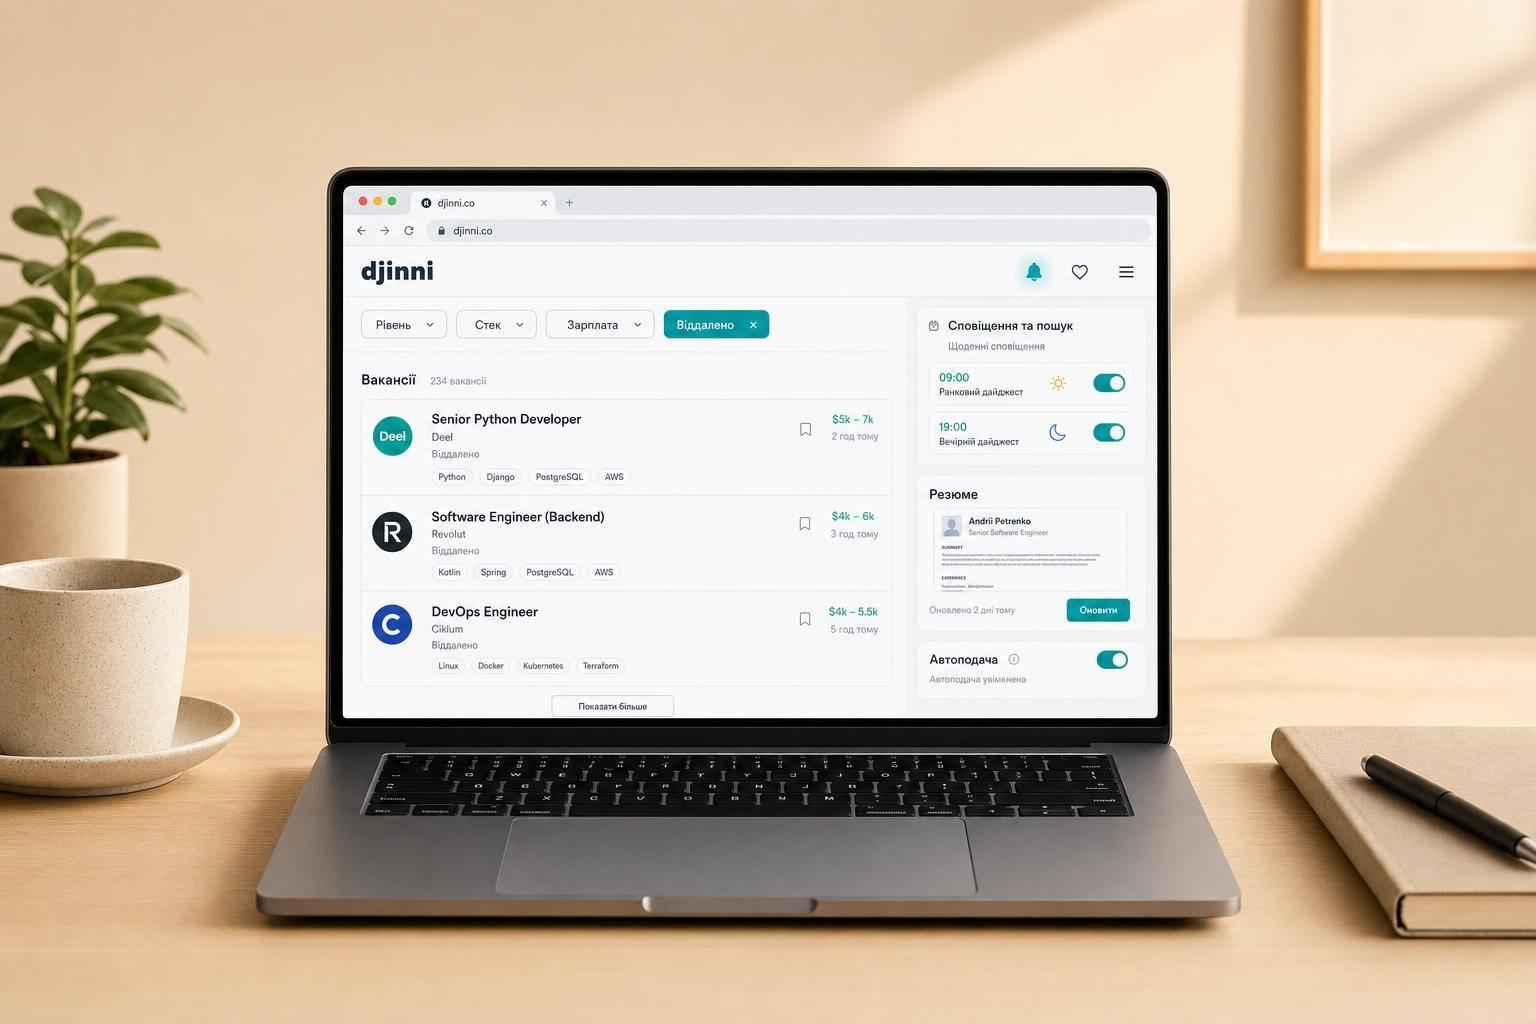
Коротко: якщо я хочу, щоб автоподача на DOU чи Djinni працювала точніше, мені треба не “прикрашати” CV, а спростити його для машинного читання.
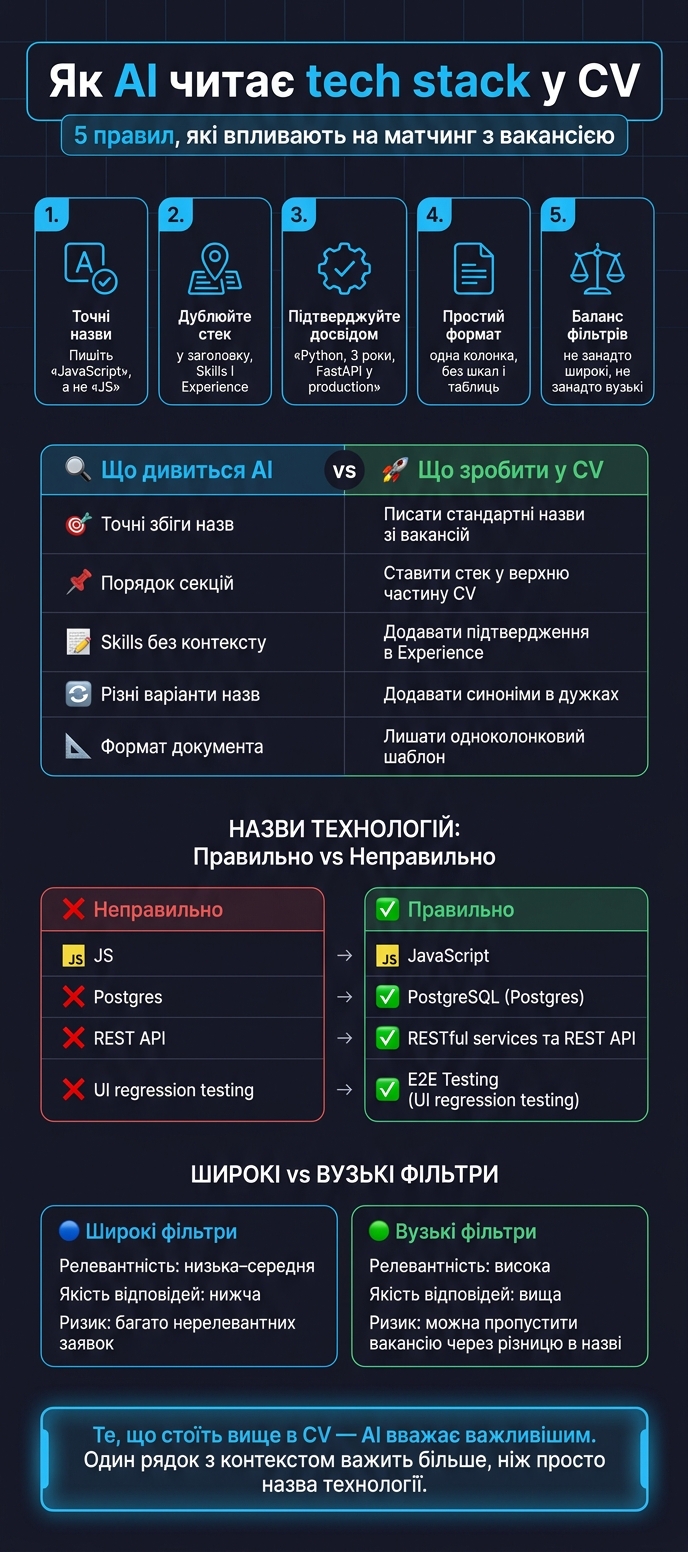
Як AI читає tech stack у CV: що працює vs що ні
Як AI та ATS розбирають tech stack у CV
AI спочатку витягує текст через OCR, а потім NLP знаходить навички, посади, дати та контекст. Далі система зіставляє профіль із вакансією. Вона шукає не просто окремі слова, а весь стек, контекст використання і рівень досвіду. Тобто «Python» сам по собі – слабкий сигнал, а от «Python (3 роки, FastAPI APIs у production)» дає системі набагато більше для розуміння.
Після того як текст розпізнано, система дивиться не лише на самі слова, а й на те, де саме вони стоять у CV.
Які секції CV сканують першими
Зазвичай система проходить CV у такому порядку: заголовок → summary → блок навичок → досвід роботи. Саме перші рядки summary часто задають seniority, стек і спеціалізацію. Якщо summary розмите, класифікація може піти не туди ще до того, як система дійде до блоку з досвідом.
Є ще один простий момент: технологія в Skills без підтвердження в досвіді читається слабше. Іншими словами, написати назву інструмента мало. Краще, щоб система одразу бачила, де і як ви його використовували.
Що робить tech stack читабельним для AI
Двоколонкові шаблони часто ламають порядок читання OCR. І це б’є не лише по вигляду CV, а й по тому, як система матчитиме ваш стек із вакансією.
Ось що прямо впливає на розпізнавання:
- Одна колонка – найнадійніший варіант для ATS-сумісного CV.
- Технології через кому або буллети – не ховайте стек у довгих абзацах.
- Без графічних шкал – «Python 80%» система не читає. Краще дати роки або контекст використання.
- Не перевантажуйте CV 30+ технологіями; краще групувати стек за категоріями: Languages, Frameworks, Infra, Databases.
Важлива й послідовність у написанні. Node.js і NodeJS для системи – це різні варіанти. Якщо в вакансіях частіше трапляється один формат, варто триматися саме його. Так менший шанс, що збіг просто проскочить повз систему.
Далі має значення, які саме назви технологій система взагалі вважає збігом.
sbb-itb-70ff7e0
Збіг ключових слів, точні терміни та синоніми
Коли стек уже поданий читабельно, далі все впирається в просту річ: чи збігаються назви у вашому CV з тим, як їх пишуть у вакансіях.
Точні назви, варіанти та типові розбіжності
Системи матчингу звіряють назви технологій із текстом вакансії. Тому навіть дрібна різниця в написанні може зменшити збіг. А це вже напряму впливає на те, які вакансії система покаже для вашого CV на DOU та Djinni.
Найчастіше проблема не в тому, що у вас немає навички. Проблема в іншому: одна й та сама технологія названа по-різному.
| У вакансії | У CV | Що зробити |
|---|---|---|
| JavaScript | JS | Писати повну назву: «JavaScript» |
| PostgreSQL | Postgres | Вказати обидва варіанти: «PostgreSQL (Postgres)» |
| QA Automation | Test Automation | Використовувати термін із вакансії та додати синонім у дужках |
| RESTful services | REST API | Включити обидва: «RESTful services та REST API» |
Наприклад, якщо вакансія просить «E2E Testing», а у CV написано «UI regression testing», система не завжди сприйме це як один і той самий термін.
Як додати синоніми, щоб CV залишалося читабельним
Найпростіший хід – додати варіант у дужках прямо в блоці Skills: «PostgreSQL (Postgres)», «JavaScript (JS)». Так ви закриваєте кілька варіантів написання для фільтрів і водночас не перевантажуєте текст.
Але тут є нюанс. У частині ATS ключове слово в Skills може важити менше, якщо воно ніде не підтверджене в Experience. Тобто сам список навичок – це добре, але ще краще показати, де саме ви цю технологію застосовували.
Тому важливі інструменти й терміни варто підкріпити хоча б одним рядком у досвіді. Коротко, по справі, з живим контекстом.
Додайте 1–2 синоніми в дужках і підтвердьте їх одним рядком у Experience.
Далі вже важливо не тільки збігтися за назвами, а й налаштувати, які вакансії система має показувати, а які – відсікати.
Include і exclude фільтри у матчингу вакансій
Далі важливо не просто збігтися за словами, а чітко задати правила відбору.
Як include-фільтри впливають на підбір вакансій
Include-фільтри – це обов’язкові умови матчингу. Вони спираються не на одне слово, а на поєднання стека, контексту й рівня. Тому Senior React Developer з досвідом у B2B SaaS і просто React Developer – для системи це два різні профілі.
Тут логіка проста: фільтри дивляться не на абстрактний “є досвід”, а на конкретні назви стеку в CV. Тобто система шукає не загальне враження від кандидата, а точні збіги з тим, що вказано у вакансії.
Як exclude-фільтри прибирають нерелевантні вакансії
Після обов’язкових збігів система так само відсікає те, що вам не підходить. Exclude прибирає небажані технології, домени й формат роботи. Наприклад:
- PHP / 1C, якщо ви з ними не працюєте
- тільки офіс, якщо шукаєте віддалену роботу
Але тут є одна пастка. Занадто широке або неточне правило exclude може закрити доступ і до потрібних вакансій. Наприклад, якщо виключити Java, деякі системи можуть випадково відфільтрувати і вакансії з JavaScript – через схожість рядків. Саме тому exclude-умови варто формулювати максимально точно.
CV Postman дає змогу налаштувати include і exclude за роллю, стеком, досвідом і локацією та автоматично подавати CV на релевантні вакансії.
Широкі vs вузькі фільтри: компроміс
Ширина фільтрів напряму впливає і на кількість вакансій, і на їхню якість. Якщо сказати простіше: що ширший фільтр, то більше охоплення, але більше шуму. Що вужчий – то точніший відбір, але є шанс щось пропустити.
| Параметр | Широкі фільтри | Вузькі фільтри |
|---|---|---|
| Релевантність | Низька – середня | Висока |
| Якість відповідей рекрутерів | Нижча, більше відмов | Вища, більше релевантних відповідей |
| Ризик | Багато нерелевантних заявок | Можна пропустити вакансію через різницю в назві |
На практиці спрацьовує не максимальна ширина, а контрольований баланс. Краще стартувати з помірно вузьких фільтрів, а далі вже дивитися по результату: розширювати include або точніше налаштовувати exclude, якщо бачите перекіс в один бік.
Де tech stack має з’являтися в CV і як це впливає на автоподачу на DOU і Djinni
Найкращі місця для згадки стеку
Після збігу ключових слів має значення не лише що є у CV, а й де саме це стоїть.
Не варто сподіватися на один збіг ключового слова. Якщо технологія згадана тільки в розділі Skills, але не з’являється в описі досвіду, її вага може бути нижчою. Тому стек краще повторити в кількох місцях CV – але не сухим списком, а в зрозумілому робочому контексті.
Найкраще працює така логіка:
- у перших рядках Skills – ключові технології з вакансії
- у заголовку CV – рівень і спеціалізація, наприклад: «Senior Full Stack Developer | React, Node.js»
- у досвіді роботи та описі проєктів – той самий стек, але вже через задачі, інструменти й результат
Такий підхід дає CV більше ваги. Система бачить не просто набір слів, а зв’язок між стеком і вашим досвідом.
Окремо добре працюють релевантні проєкти з тим самим стеком і лінком на GitHub. Це теж підсилює матчинг.
Як формулювання стеку впливає на точність автоподачі
На DOU і Djinni це прямо впливає на точність автоподачі.
Коли назви технологій у CV збігаються з формулюваннями у вакансії, автоподача спрацьовує точніше. CV Postman автоматично подає CV на релевантні вакансії на dou.ua і djinni.co, і точність автоподачі тут прямо залежить від того, наскільки ясно описаний стек у вихідному CV.
Якщо в CV є лише назва технології без пояснення, системі складніше зіставити стек із вакансією. А от формулювання у форматі CV дає одразу три сигнали: стек, рівень і результат.
Playwright + TypeScript regression harness; test time 45 → 6 хв.
Це вже не просто згадка інструментів. Тут одразу видно, з чим ви працювали, на якому рівні це застосовували і що отримали на виході. Саме такі формулювання зазвичай дають точніший збіг під час автоподачі.
Висновок: що змінити в CV, щоб AI підбирав правильні вакансії
Після синонімів, include та exclude лишається останній крок: зробити CV простим для читання AI. Правильні вакансії підтягуються тоді, коли назви технологій, їхній порядок і формат запису збігаються з тим, як система звикла їх розпізнавати.
Ось що варто зробити:
- Використовуйте стандартні назви технологій, а головні зв’язки у стеку ставте на початок CV.
- Винесіть 3–4 найрелевантніші технології у верхню частину CV або в короткий технічний блок.
- Технології, з якими ви вже не хочете працювати, краще не виділяти. Так профіль не розмивається, а логіка include/exclude працює точніше.
Тут важливий не лише сам список технологій, а й їхнє місце в документі. Якщо говорити просто: те, що стоїть вище, AI зазвичай зчитує як більш важливе.
Також має значення формат. Одноколонковий CV без таблиць, іконок і графічних шкал AI читає точніше.
Якщо CV оформлене у стандартному форматі, CV Postman подає CV лише на вакансії з точним збігом за стеком на dou.ua і djinni.co.
FAQs
Чи треба адаптувати CV під кожну вакансію?
Так. ATS і рекрутери дивляться, наскільки CV збігається з вакансією за ключовими словами, tech stack і досвідом. Якщо у CV немає точних термінів з опису позиції, документ може отримати нижчу релевантність і просто залишитися непоміченим.
Робити це вручну під кожну вакансію довго й виснажливо. Саме тому цей процес можна автоматизувати через CV Postman: сервіс підлаштовує CV під вимоги позиції та автоматично надсилає відгуки.
Які слова в CV найчастіше ламають матчинг?
Найчастіше матчинг ламають ключові слова без контексту, графічні елементи, невідповідність термінології вакансії та пасивні формулювання.
Ось де кандидати найчастіше спотикаються:
- довгі списки технологій без підтвердження в досвіді;
- шкали, таблиці, текстові бокси та іконки в PDF;
- синоніми, що не збігаються з текстом вакансії;
- шаблонні фрази замість дій і результатів.
Як перевірити, чи моє CV правильно читається ATS?
Переконайтеся, що ваше CV збережене у форматі текстового PDF або DOCX, а не як зображення. Це дрібниця лише на перший погляд. Якщо файл складно зчитати, частина даних може просто загубитися.
Найкраще працює одноколонковий формат із чіткою структурою та стандартними заголовками. Чим простіше оформлення, тим краще. Варто уникати колонок, таблиць, іконок, графіки та діаграм навичок, бо все це часто заважає коректному зчитуванню.
Також можна скористатися онлайн-інструментами для аудиту ATS. Вони допомагають швидко побачити, чи немає проблем із форматом, структурою або ключовими словами.
І ще один важливий момент: навички та ключові слова з вакансії варто вбудовувати в опис вашого досвіду, а не залишати лише в окремому списку. Тобто не просто писати "SEO", "Excel", "управління проєктами", а показувати, де саме і як ви це застосовували на практиці.